风险分层治理框架
从价值观、信息质量、AI 系统攻击三层建立风险评分、证据保全和责任归属。
4. 风险分层治理框架
4.1 价值观层治理:先判断目的是否正当
价值观层的风险往往不依赖 AI 技术。即使没有大模型,虚假评论、竞品诋毁、隐性付费、刷量和伪交易也会伤害用户与市场。AI 搜索放大了这些行为的影响,因为模型会把开放网络中的多源噪声压缩成看似简洁的结论。
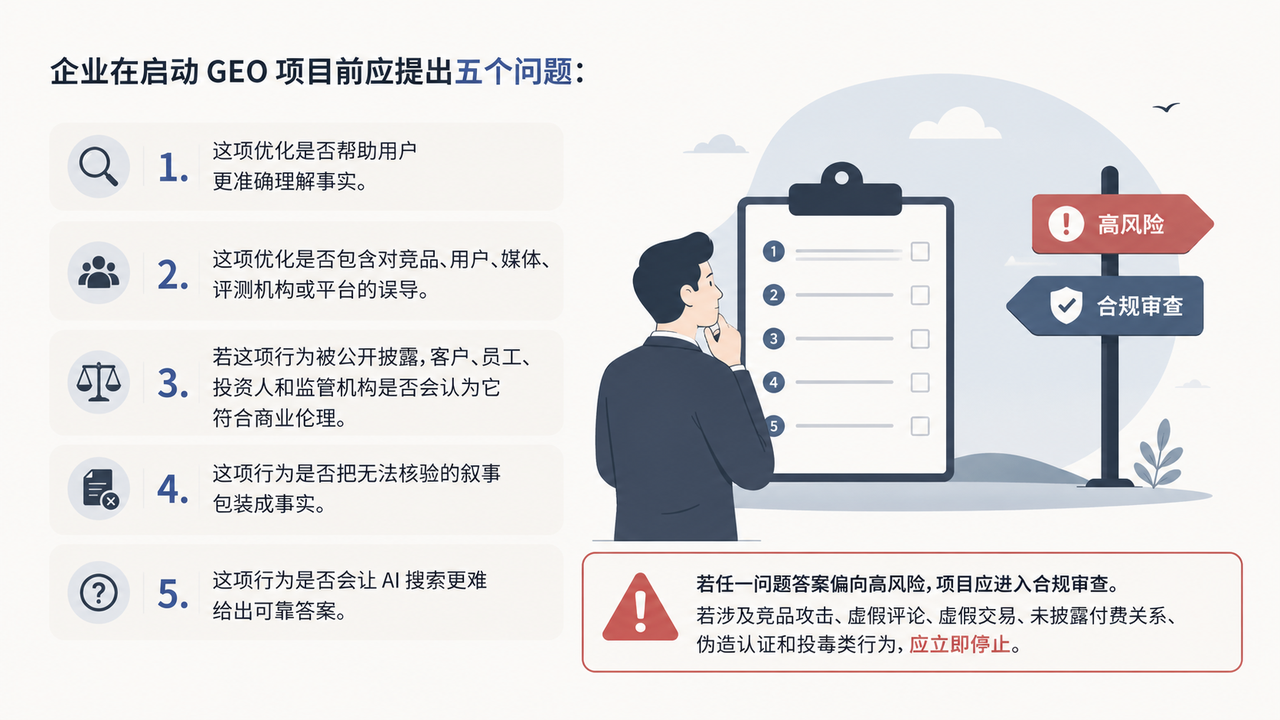
企业在启动GEO项目前应提出五个问题:
-
这项优化是否帮助用户更准确理解事实。
-
这项优化是否包含对竞品、用户、媒体、评测机构或平台的误导。
-
若这项行为被公开披露,客户、员工、投资人和监管机构是否会认为它符合商业伦理。
-
这项行为是否把无法核验的叙事包装成事实。
-
这项行为是否会让 AI 搜索更难给出可靠答案。
若任一问题答案偏向高风险,项目应进入合规审查。若涉及竞品攻击、虚假评论、虚假交易、未披露付费关系、伪造认证和投毒类行为,应立即停止。
4.2 信息质量层治理:把“可被 AI 读取”视为发布责任
面向 AI 搜索的内容会被抓取、摘要、重写、引用和跨语言传播。发布责任不再限于页面本身,还包括页面进入 AI 生态后的二次影响。
建议建立八项内容控制:
-
事实清单:每个事实性主张都对应来源、证据和更新时间。
-
声明等级:区分事实、观点、预测、客户反馈、案例、统计推断和广告承诺。
-
引用校验:核验 DOI、报告链接、证书编号、媒体报道、客户授权和数据口径。
-
YMYL 审校:医疗、金融、法律、安全、公共事务内容应有专业审校和风险提示。
-
AI 生成标记:内部记录 AI 参与程度,必要时向外披露生成或编辑方式。
-
结构化数据一致性:schema、FAQ、review、price、availability 必须与可见内容一致。
-
更新日志:关键页面保留更新时间、更新内容和审校人。
-
撤回机制:错误内容能快速下线、改正、通知相关方并阻止继续进入知识库。
4.3 AI系统攻击层治理:把内容当成潜在输入面
GEO页面、新闻稿、FAQ、PDF、图片 alt 文本、评论、论坛、案例库、帮助中心和公开知识库都会成为 AI系统输入。企业需要把内容安全接入应用安全流程。
建议采用六道防线:
-
来源分级:将官网、法务审校页面、客户授权案例、UGC、第三方转载、未知来源分级处理。
-
指令隔离:RAG 和 agent 系统必须把外部内容标记为数据,不能让外部文本覆盖系统目标。
-
检索校验:对高影响答案使用多来源交叉验证,避免单一片段决定答案。
-
权限最小化:AI agent 不应在无确认状态下执行高影响工具动作。
-
输出清洗:HTML、Markdown、链接、脚本、SQL、命令和邮件输出都要经过验证。
-
日志与回放:保留 query、检索片段、模型输出、工具调用和人工确认,便于追责和复盘。
4.4 风险评分矩阵
-
1 低:表达不清、引用格式不完整或轻微过期。处置方式是由内容团队修正,记录版本。
-
2 中低:证据不足、披露不充分或结构化数据轻微不一致。处置方式是补证据、补披露,并下线不准确的富结果标记。
-
3 中:可能误导用户、存在未审校 AI 内容或竞品比较证据不足。处置方式是暂停发布,由法务和合规复核。
-
4 高:涉及虚假宣传、虚假评论、批量低质内容、站点声誉滥用或过期域名滥用。处置方式是立即下线,通知客户并启动整改。
-
5 严重:涉及竞品攻击、RAG 投毒、提示词注入、恶意搜索投毒、敏感信息泄露或模型供应链污染。处置方式是终止行为、保全证据、启动安全响应,必要时通知监管或受影响方。
4.5 证据保全要求
发现风险后,不要只删除页面。应先保全可复核证据:
-
页面 URL、发布时间、更新记录、作者、审校人、供应商、项目负责人。
-
页面截图、源代码、schema、robots、sitemap、服务器日志、Search Console 记录。
-
AI 搜索输出截图、query、时间、地区、语言、模型或产品版本、引用链接。
-
合同、Brief、交付物、审批记录、客户确认记录、外包沟通记录。
-
对RAG风险,保留检索片段、知识库版本、向量索引版本和模型输出。
4.6 责任归属模型
GEO风险常见责任链包括客户、服务商、外包写手、媒体渠道、技术供应商、数据供应商和平台。
合同应明确:
-
服务商不得实施或协助实施虚假信息、竞品攻击、提示词注入、RAG 投毒、链接作弊、虚假评论、虚假交易。
-
客户提供的事实素材必须真实、合法、可授权使用。
-
所有第三方内容和媒体关系必须披露利益关系。
-
自动化内容必须有人类审校和事实核查。
-
供应商使用的模型、插件、爬虫、监控工具和数据源需要安全说明。
-
发现红线行为后,服务商有暂停交付、要求整改、终止合作和保全证据的权利。